集群状态同步与缓存
Kuboard 将常用 Kubernetes 对象同步到本地数据库(缓存),资源列表从缓存查询,而不是每次请求都穿透到集群,从而降低对集群的访问压力。
缓存让列表的分页、筛选、排序等功能得以在本地实现。适用对象:集群运维 / 管理员。本文说明缓存如何同步、参数在哪配置,以及「同步状态」页上能做哪些操作。
三种同步模式
每种资源的同步方式,在设置 → 系统设置 → 集群缓存设置中指定:
| 模式 | 数据更新方式 | 适用场景 |
|---|---|---|
| watch(实时监听) | 集群中对象变更后立即更新缓存 | Pod、Deployment、Service 等频繁变更的资源 |
| polling(定时轮询) | 每隔固定时间整体刷新一次 | Namespace、Secret、Ingress 等变更不频繁的资源 |
| nocache(直连不缓存) | 不写入缓存,每次查询直接访问集群 | 冷门资源、未列入缓存配置的资源 |
默认行为
未在缓存设置中列出的资源,默认按 nocache 直连处理,不产生本地缓存。
缓存资源配置
在设置 → 系统设置 → 集群缓存设置中集中维护,保存后立即生效,无需重启服务。配置分三部分:
- 同步线程池:设置同时执行同步任务的最小 / 最大线程数;
- 同步时间控制:全量同步的超时与失败重试、增量同步每轮监听的周期与间隔等;
- 缓存对象设置:为每种资源选择同步方式(watch 或 polling)及轮询间隔;events 资源可单独设置删除后的保留时长。
默认缓存资源如下,可按需调整:
- watch:pod、deployment、statefulset、daemonset、service、endpoint、endpointslice、event(默认删除后保留 168 小时)及 DRA 资源;
- polling(每 5 分钟):namespace、node、configmap、secret、persistentvolumeclaim、ingress、networkpolicy、horizontalpodautoscaler、job、cronjob、role、rolebinding、serviceaccount、customresourcedefinition;
- polling(每 300 分钟):各类 admission webhook 配置、validatingadmissionpolicy 及其绑定、flowschema、prioritylevelconfiguration、runtimeclass。
集群状态(缓存健康)
集群管理列表中,每个集群的集群状态列显示缓存健康状态:
| 状态 | 含义 |
|---|---|
| unknown | 集群刚导入时的初始状态 |
| ready | 缓存可用,资源列表正常从缓存读取 |
| error | 与集群失联,缓存查询返回空结果 |
集群失联(error)后无需人工干预:集群恢复连通后会自动回到 ready。想查看失联原因,可在集群管理列表点开集群,查看失联原因与检查时间。
状态同步页
在集群详情 → 同步状态标签页,可以查看该集群每种资源的同步明细。
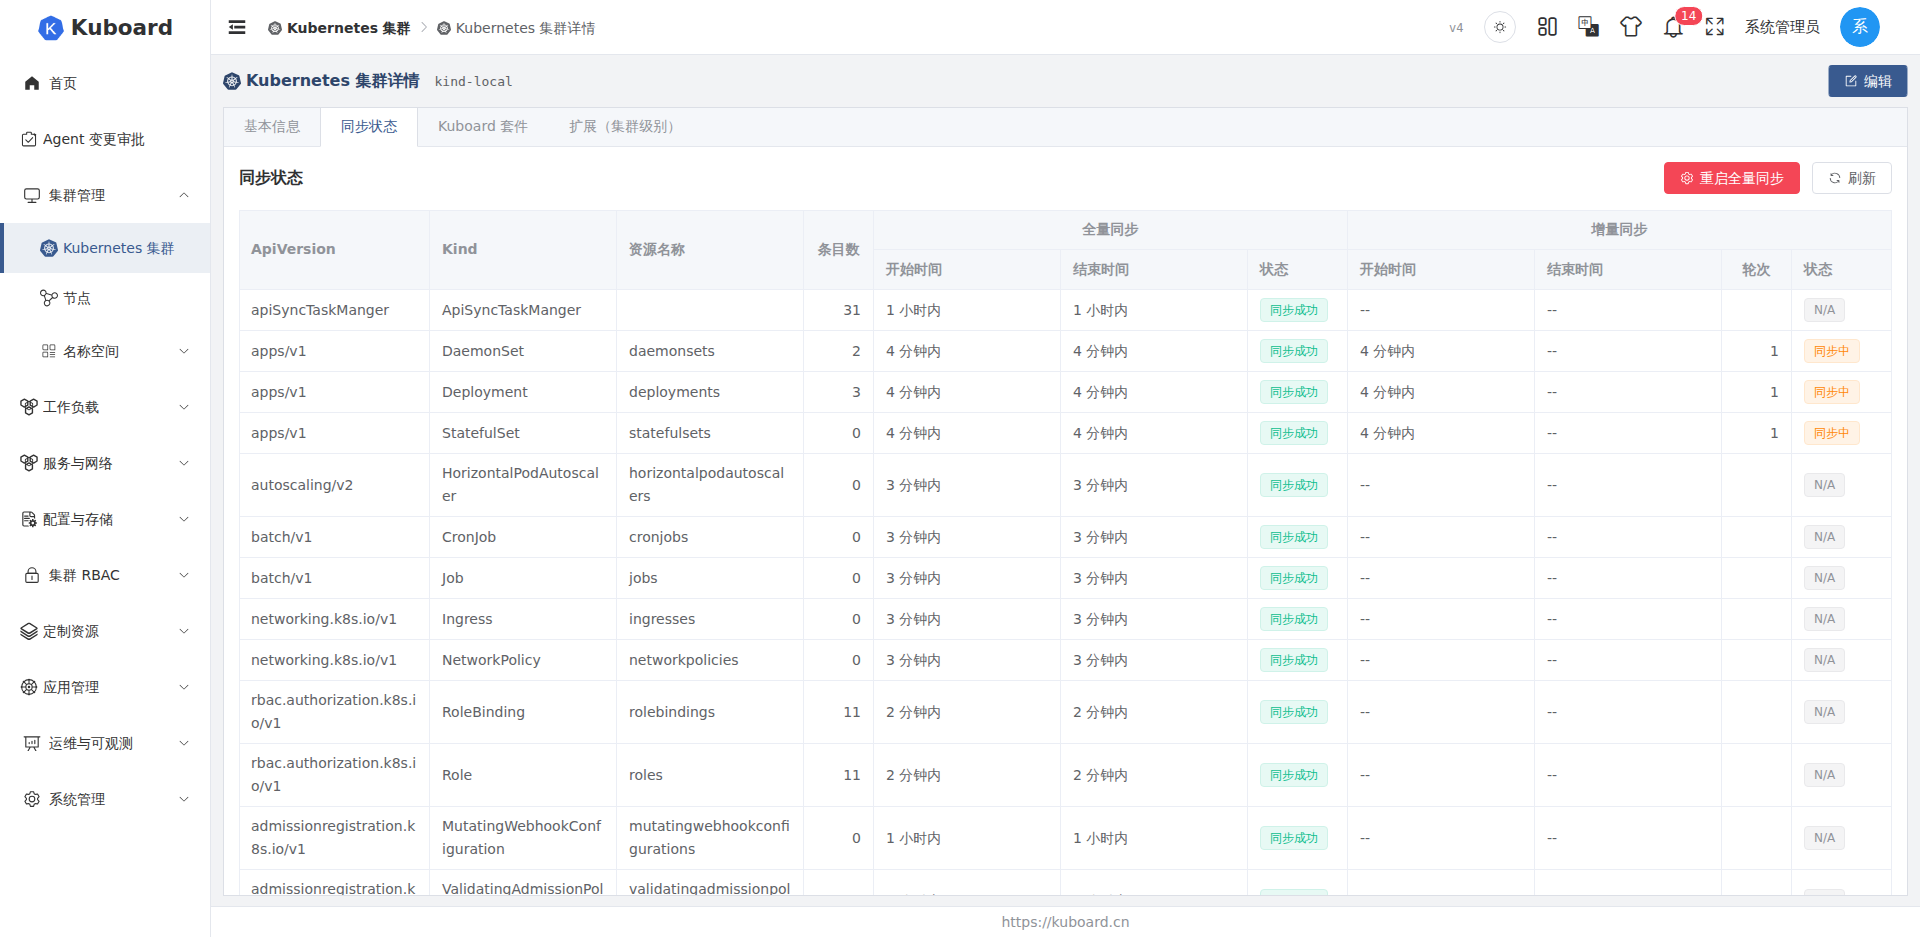
表格每个资源一行,主要列:
| 列 | 说明 |
|---|---|
| 资源类型(ApiVersion / Kind / 资源名称) | 同步的资源 |
| 更新方式 | 该资源当前的同步方式(监听 / 轮询 / 无缓存) |
| 条目数 | 当前缓存中该资源的对象数量 |
| 全量同步 | 开始时间、结束时间与状态 |
| 增量同步 | 开始时间、结束时间、轮次与状态 |
同步状态取值为:created(任务已创建,等待执行)、processing(执行中)、failed(失败)、success(成功)。页面上有两个操作按钮:
- 重启全量同步(危险操作):删除该集群全部同步任务,按当前缓存设置重新生成任务并逐资源执行全量同步,相当于重建一次缓存;
- 刷新:重新加载表格数据。
同步进行中看到什么
大集群的全量同步动辄十几分钟。这期间页面每 5 秒自动刷新一次,条目数一栏显示实时进展:
- 正在同步的资源,条目数显示为「已同步 N 条(第 P 页)」——N 是已写入缓存的对象数,P 是已翻过的分页数;
- 页面切到后台标签时暂停刷新,切回来立即补一次;
- 全部资源同步完成后自动停止刷新。
同步中显示 0 条是正常的
同步刚开始、或本实例不是正在执行同步的那个实例时,进展数字暂时拿不到,条目数显示为占位符而不是 0。这不代表异常——等数字出现即可。
重启全量同步须知
该操作会把集群导入状态改回「导入中」;单个资源会先删除旧缓存、再写入新数据,期间对应资源列表可能短暂为空或不完整。集群较多、资源量大时应避开业务高峰。
同步异常:受限同步与失败原因
同步列表里除正常状态外,还会出现两类需要关注的标记。
受限同步
当某类资源的数据量过大,Kuboard 判断它无法在集群的变更窗口内完成一次全量同步时,会把该资源标记为「受限同步」。
含义:缓存数据仍然可读,但不是最新的 —— 每次全量同步刚写完就再次失效。在集群详情 → 同步状态页展开该资源,可以看到一句话结论与实测证据:
- 结论:单轮全量需约 N 分钟,而本集群的变更窗口只有约 M 秒;
- 证据:当前对象数 X,最近触发 Y 次全量同步,最长稳定期 Z 分钟。
Kuboard 给出三条建议:
| 建议 | 说明 |
|---|---|
| 改为直查(不使用缓存) | 该资源每次直接读集群,跳过本地缓存。数据最新,代价是集群较多时列表变慢。任何情况下都可用 |
| 提升数据库写入能力 | 数据库写入吞吐不足时,会给出「至少需要多少行/秒」 |
| 改为定时刷新 | 按单轮全量的实测耗时给出建议的刷新间隔(下限 5 分钟) |
同一结论还会出现在平台健康诊断页(检测项「资源同步受限」)、消息中心待办与缓存状态弹窗。
受限同步不是故障
数据仍在,可继续使用最后一份快照。若该资源本来就不要求实时,改为定时刷新或直查即可。
同步失败原因
同步失败时展开该资源,会看到一张「失败原因」卡片:失败原因(一句话分类)、当前影响(数据仍在 / 暂无可用数据)、可能原因(0~2 条)、可以这样处理(可执行动作,部分可直接点击跳转)。
| 失败原因 | 含义 | 可以这样处理 |
|---|---|---|
| 无法连接集群 | 网络不通、连接被拒、证书握手失败、读超时 | 检查集群地址与网络 |
| 凭据无效或权限不足 | 导入集群用的凭据过期,或权限已被回收 | 更新集群凭据 |
| 集群数据变化过快,本次同步中途失效 | 资源变更频繁,分页读取期间数据已发生变化 | 稍后重试(平台会自动重试) |
| 集群在时限内没有返回完整数据 | 集群响应超时或对请求做了限流 | 稍后重试;也可改为直查 |
| 集群内部错误 | 集群自身返回了错误 | 稍后重试 |
| 单次返回的数据过大 | 单页数据量超过 Kuboard 可处理的体量 | 调小单页数据量 |
| 数据库写入失败 | 数据库连接、锁或磁盘压力 | 提升数据库写入能力 |
| 未能识别具体原因 | 以上都不匹配时的兜底 | 查看同步日志定位 |
原始报错在哪
「技术详情」折叠区里有请求地址、状态码与集群返回的原始报文,反馈问题时请一并提供。其余位置只显示归类后的结论,不展示原始报文。
常见问题
某个资源的列表始终为空
依次检查:该资源是否已加入集群缓存设置(未配置的资源走直连,无本地缓存);集群健康状态是否为 ready(失联集群查询返回空);若是新加入缓存的资源,需在同步状态页点一次重启全量同步。
同步显示成功,但列表里少了对象
旧版本存在一个缺陷:全量同步按固定页数截断,被截断时仍记为「同步成功」,界面看不出问题,实际缓存里缺了一部分对象。升级到当前版本后该缺陷已修复——同步会一直翻到最后一页,中途异常一律记为「同步失败」。
若你在旧版本上同步过、之后直接沿用旧缓存,缺失的对象不会自动补回。处理方式:到同步状态页点一次重启全量同步,重建缓存。
切换同步方式后,缓存没有按预期工作
已存在的任务会在下一轮按新配置生效;但新增或移除资源不会自动生成、清理任务。修改缓存设置后,请在各集群的同步状态页点击重启全量同步,按最新配置重建同步任务与缓存。
集群失联后,资源列表不可用
失联集群的健康状态为 error,缓存查询返回空结果。恢复集群连通后会自动回到 ready,无需操作。
events 在集群中删除后仍能看到
events 默认在删除后保留 168 小时,便于事后排查问题。可在集群缓存设置中调整该保留时长。
提示 resourceVersion 过期(410 Gone)
watch 监听携带的版本号过期(如集群重启)时会提示 410 Gone,属正常现象。Kuboard 会自动重新建立监听,无需处理。
大集群同步慢是正常的
对象数量大时全量同步需要十几分钟甚至更久,期间页面会自动刷新并显示已同步条数。只要数字在涨就说明在正常推进;长时间数字不动,才需要排查(见上一条「无进展多久重启全量同步」配置项)。
接口文档
本节涉及的接口详见 Swagger UI 的「集群管理接口」分组。